Gemini 4 Argon 发布:单次输出拉到 100 万 Token,Google 把旗舰推理砍至半价
Google 于 2026 年 9 月 30 日发布新一代旗舰模型 Gemini 4 Argon,单次输出上限提升至 100 万 Token,初始 API 价格低至输入 2 美元、输出 10 美元。模型在长程软件工程与知识密集型任务中取得新突破,但首发仅开放给受信任的网络安全防御团队。
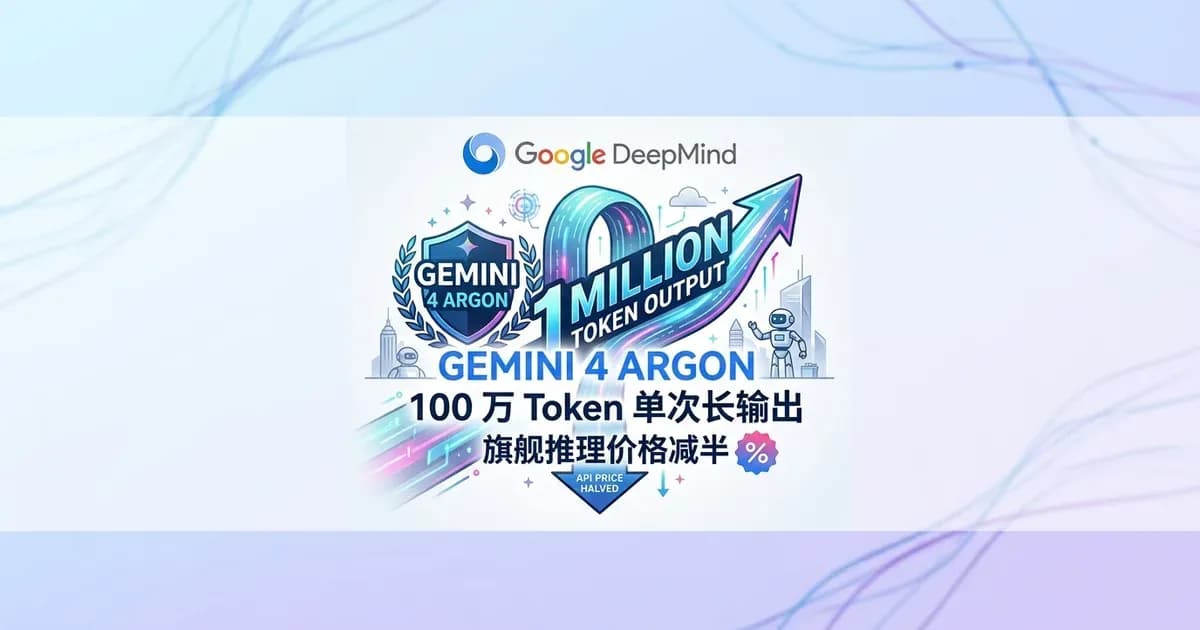
Google DeepMind 于 2026 年 9 月 30 日发布 Gemini 4 世代首款前沿旗舰模型 Gemini 4 Argon。与过去频繁更新的轻量 Flash 系列不同,Argon 瞄准的是超长周期、高复杂度的专业工程与知识工作,覆盖软件工程、法律与金融分析以及网络安全防御。
这次发布带来了两个最具破坏性的变化:第一,模型的单次输出上限从行业通行的 6.4 万至 12.8 万 Token 直接拉升至 100 万 Token;第二,Google 拿出了极具进攻性的初始定价,输入每百万 Token 2 美元、输出 10 美元,将顶级旗舰模型的调用价格压到 Claude Opus 5.5 的一半、GPT-6 Astra 的五分之一。
不过,普通开发者和企业用户眼下还无法直接调用。Google 采取了严格的分阶段发布策略,首批模型仅通过 Fairwind Program 交付给受信任的网络安全防御团队。
100 万 Token 单次输出突破长程 Agent 的执行瓶颈
在大模型落地 Agent 工作流的过程中,输出长度限制一直是工程团队难以绕开的痛点。此前包括 GPT-6 Astra 和 Claude Opus 5.5 在内的旗舰模型,上下文窗口虽然普遍达到数百万 Token,但单次输出上限多被限制在 6.4 万至 12.8 万 Token 之间。
单次输出上限与上下文输入窗口是两个完全不同的概念。当开发者尝试让 Agent 执行整库代码重构、跨模块系统迁移或编写上百页的端到端技术规范时,过短的输出上限会导致任务被强行切碎。开发者必须编写复杂的外挂状态机,让模型分批生成、频繁接力,中途极易出现上下文丢失、符号引用断裂和死循环。
Gemini 4 Argon 将单次连续生成能力放开到 100 万 Token,意味着模型可以在单一任务轨迹内持续推理,直接吐出数万行完整的生产级代码或数十万字的系统交付物。这种架构升级本质上是在减少任务中断的次数,把原本需要多轮人机交互或脆弱编排脚本的任务,收拢为一次端到端的深层执行。
初始价格砍半,但长期预算需按标准价格推演
除了输出规格,Google 在定价上的动作同样打破了过去旗舰模型高高在上的惯例。
模型 | 输入价格(美元/百万 Token) | 输出价格(美元/百万 Token) | 缓存输入(美元/百万 Token) |
|---|---|---|---|
Gemini 4 Argon(初始价) | 2.00 | 10.00 | 0.10 |
Gemini 4 Argon(标准预估价) | 4.00 | 20.00 | 0.20 |
Claude Opus 5.5 | 4.00 | 20.00 | 0.40 |
GPT-6 Astra | 10.00 | 50.00 | 1.25 |
按照 100 万 Token 输入搭配 20 万 Token 输出的中型分析任务计算:
- 使用 GPT-6 Astra 的单次理论成本为 20 美元;
- 使用 Claude Opus 5.5 的成本为 8 美元;
- 使用 Gemini 4 Argon 初始价仅需 4 美元。
在缓存输入方面,Argon 给出了高达 95% 的折扣,缓存后每百万 Token 输入费用仅为 0.10 美元。根据第三方基准分析测算,Argon 的单任务综合成本约 1.99 美元,比 GPT-6 Astra 降低了约 40%。
但需要提醒技术选型团队的是,Google 官方将当前 2/10 美元的费率明确标注为“介绍价”(Introductory Pricing)。推广期结束后,标准价格预计将调整为输入 4 美元、输出 20 美元。团队在搭建业务 ROI 模型时,必须留出价格回调的安全余量,避免因为短期低价在生产环境中产生错误的成本预期。
基准跑分与内部实测:强在知识工程,编程并非全面领跑
在 Google DeepMind 公布的评测数据中,Gemini 4 Argon 在知识密集型任务和部分长程工程任务中刷新了记录,但在传统编码基准中并非全维胜出。
测试基准 | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra | 评估重点 |
|---|---|---|---|---|
DeepSWE v1.1 | 77.9% | 72.1% | 74.3% | 长程软件工程任务完成率 |
FrontierSWE v2 | 55.0% | 58.2% | 65.5% | 复杂前沿代码问题排查 |
Terminal-bench 4.0 | 57.4% | 66.4% | 61.8% | 命令行与真实终端操作 |
Vals Index | 68.9% | 67.0% | 63.1% | 金融、法律、税务等专业知识综合加权 |
Harvey Legal Agent | 19.6% | 3.8% | 5.4% | 专业法律复杂推理与审查 |
AutomationBench | 51.3% | 42.5% | 31.4% | 企业端到端业务工作流自动化 |
CWE-bench v1 | 68.0% | 61.5% | 68.0% | 网络安全已知软件漏洞修复 |
数据反映出明显的取向特征:
- 企业知识工作优势突出:在衡量真实商业环境知识处理的 Vals Index(按美国 GDP 产业贡献加权)中,Argon 位居第一;而在法律领域极具难度的 Harvey 基准测试中,Argon 跑出 19.6%,这一成绩超过了同组另外三款对比模型的总和。
- 长程软件工程刷新记录:DeepSWE v1.1 侧重测试 Agent 跨文件、多依赖的长周期调试与修改,Argon 以 77.9% 登顶。
- 终端交互与部分极限问题仍存短板:在涉及实际终端工具链调用的 Terminal-bench 4.0 上,Argon 明显落后于 Claude Opus 5.5(57.4% 对 66.4%);在 FrontierSWE v2 上也落后于 GPT-6 Astra(55.0% 对 65.5%)。
相比纸面跑分,Google 公布的内部工程应用数据更为具体:
- 数据中心集群内存优化:一组 Argon 驱动的 Agent 分析了全网服务器性能遥测日志,自主生成并部署内存回收策略,已释放超 300 TiB 内存,预计整个优化周期总节省量在 500 TiB 至 1 PiB 之间。
- 大规模底层代码向 Rust 迁移:Argon 参与了 Google 内部 C/C++ 代码迁移,重写了开源视频解码器 libgav1 中约 3.2 万行 SIMD 代码,迁移后的 Rust 实现运行速度达到原 Rust 版本的 2.7 倍,并进一步承接了超过 80 万行 Fuchsia Zircon 内核的迁移探索。
- 量子计算算法开销缩减:研究人员借助 Argon 优化量子线路的时空资源(量子比特数与门操作数乘积),在几分钟内将已发表的基准结果提升了 40%。
- 未知系统漏洞挖掘:安全厂商 Wiz 在与 Google 合作的“Scan for Good”项目中接入 Argon,成功挖掘出一项影响全球多国医院医疗软件的高危未公开漏洞。
首发仅限网络安全:普通开发者的排队节奏与内部争议
尽管官方展示的成果引人注目,但普通开发者短期内依然无法在控制台点击启用。
Google 这次采取了极为谨慎的四阶段分发机制:
- 第一阶段(当前):仅通过 Fairwind Program 面向经过资质筛选的受信任网络安全防御团队开放,用于关键基础设施防御和红蓝攻防对抗,同时配合美国政府的人工智能预发布自愿合规评估。
- 第二阶段:向已开通付费账单的 Gemini API 客户以及 Google AI Ultra 订阅者开放。
- 第三阶段与第四阶段:逐步扩展到企业级工作平台及个人消费端。
Google 在官方技术说明中解释,这种节奏是因为高能力长输出模型伴随着更高的潜在风险。为了防范间接提示注入(Indirect Prompt Injection)和任务目标偏离,Google 引入了思维链持续监控、高风险沙箱环境隔离等防护措施,需要在封闭受控环境下收集反馈后再扩大范围。
真实生产力体验也并非毫无杂音。彭博社援引知情人士透露,Google 内部部分研发员工对 Gemini 4 在真实编码任务中的表现依然存有疑虑。有员工反馈,尽管模型在公开基准集上表现出色,但在处理复杂的内部非标代码工程时,偶发性的推理断层和逻辑幻觉依然会增加人工介入排查的负担。
独立开发者与小团队的选型建议与落地准备
对于资金和算力有限的独立开发者、一人公司(OPC)及初创小团队,Gemini 4 Argon 的发布指明了下一阶段 AI 架构的迁移方向,但也需要理性的工程定力。
1. 重新审视长输出场景的工作流设计
过去受限于 64K 输出,团队往往在外部架构上过度设计(例如拆分为多个子 Agent、反复维护分段状态库)。100 万 Token 输出普及后,代码迁移、全量合同扫描、整套数据库迁移脚本生成等任务,可以优先尝试单一上下文的大输出方案,大幅降低外部状态同步带来的系统脆弱性。
2. 提前储备真实任务评估集,而不是盲信基准
正如内部反馈所揭示的,跑分高的模型并不等同于在你的代码库里一次通过。建议小团队从现在开始归档业务中的典型故障场景:
- 一次典型的生产 Issue 修复链路(包含定位、复现用例、修改补丁与回归);
- 一段跨依赖的框架升级改造;
- 一份真实的业务数据接口对齐任务。
在第二批 API 权限开放后,用这套私有测试集对照 Gemini 4 Argon、Claude Opus 5.5 和本地主力模型,评估真实的任务一次通过率与人工修复耗时。
3. 当前开发工作依然立足可用模型
由于 Argon 尚未对公开放,当前有 Google 生态调用需求的小团队,主力仍应是成熟高频的 Gemini 3.8 Flash;涉及复杂推理和终端执行的场景,依然可以继续使用 Claude Opus 5.5 或 GPT-6 系列作为兜底方案。提前在 Google AI Studio 中配置好付费凭据与配额权限,等待开放通知即可无缝切入。
决定 Agent 长期竞争力的不是跑分榜上的峰值,而是在真实工程中能够免人工干预稳定交付的完成率。