TypeSafe 推出首个决策模型 Jev:砍掉文本生成专攻结构化判断,重构 Agent 底层调用
前 OpenAI 研究员 Diogo Almeida 创立的 TypeSafe AI 发布首个“系统一”决策模型 Jev。该模型彻底摒弃自回归文本生成,专注高频结构化选择、评分与概率输出,输入每百万 Token 仅 0.042 美元且输出免费。
2026 年 9 月 15 日,获得 DCVC 领投 4000 万美元种子轮融资的旧金山初创团队 TypeSafe AI 正式走出隐身模式,发布了其首个被称为“系统一模型”(System One Models)的基础模型 Jev。
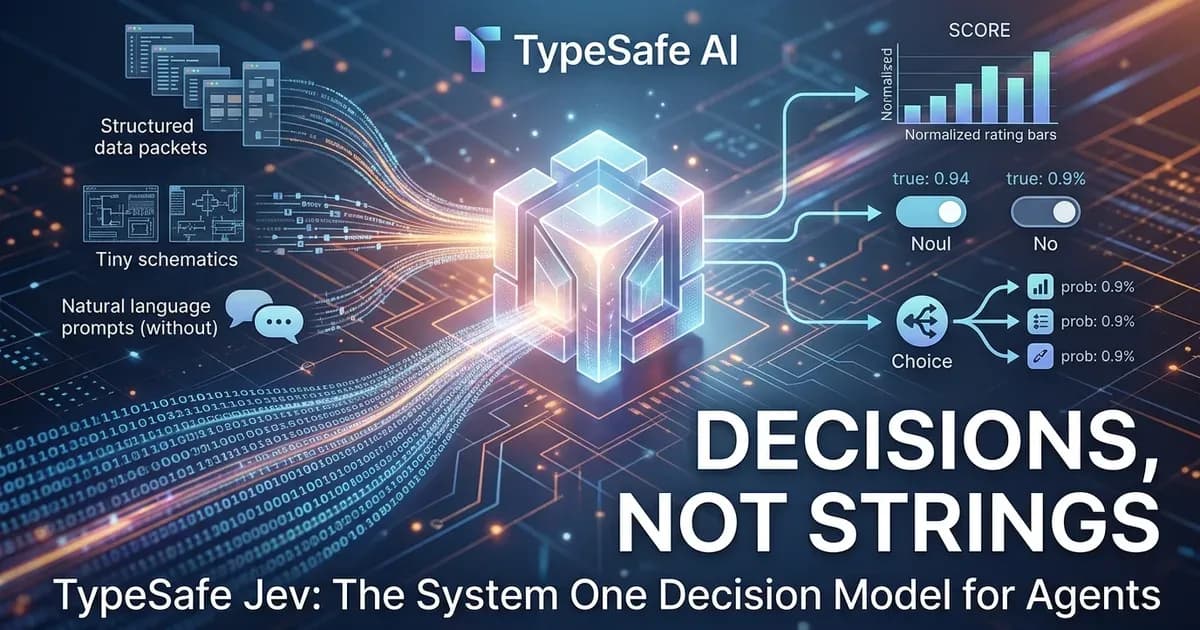
与当下主流大语言模型竞相提高上下文窗口或对话泛化能力不同,Jev 做出了一个看似极端的取舍:彻底砍掉自回归文本生成能力。它不写文章、不补全代码,也不参与开放式人机对话,而是将全部能力聚焦于软件系统内部的高频判断。TypeSafe 将其核心设计原则概括为“Decisions, not strings”——要决策,不要文本。
Jev 接收结构化程序状态或自然语言信息,并围绕预设问题直接返回选项、等级评分与对应概率。其端到端调用延迟在 70 至 500 毫秒之间,API 计费仅收取每百万输入 Token 0.042 美元,输出 Token 永久免费。在官方公布的特定生产工作流评测中,该模型相比大型生成式基线模型实现了最高 193.6 倍的速度提升与 444.6 倍的成本降低。这一特性迅速引起了 Agent 开发者与开源社区的广泛测试。
为什么 Agent 系统需要一个“不说话”的模型?
当前大语言模型(如 GPT、Claude 与 Gemini 系列)的底层运作机制建立在自回归采样之上:根据已有上下文依次预测下一个 Token。这一机制赋予了模型自由写作、复杂长程推理与自然交互的能力,但也让单次调用的计算开销和延迟随输出长度线性增长。
然而在现代 AI Agent 架构中,系统内部发生的大量模型调用并不面向人类读者。例如:
- 浏览器 Agent 需要判断下一步应该点击屏幕上的哪一个按钮;
- 研发 Agent 执行完终端命令后需要确认单元测试是否通过;
- 客服流水线需要评估一条输入是否为销售线索并决定指派部门;
- 会话上下文管理器需要筛选哪些历史工具日志可以从上下文窗口中剔除。
在传统工作流里,开发者通常把状态拼接为提示词传给通用模型,等待其输出一段“根据以上信息,应选择……”的自然语言或嵌套 JSON 字符串,随后通过正则表达式提取最终答案。这一过程不仅浪费了数秒等待时间与输出 Token 费用,还伴随格式解析失败的脆弱性。
TypeSafe 采用“System One Models”命名该模型,灵感源自认知心理学家丹尼尔·卡尼曼在《思考,快与慢》中划分的“系统 1”——负责快速、自动化、直觉式的判断。而模型代号“Jev”则取自 19 世纪英国经济学家威廉·斯坦利·杰文斯(William Stanley Jevons)。根据经济学中的“杰文斯悖论”,当某种关键资源的使用效率得到大幅提升、成本显著下降时,该资源的总消耗量非但不会减少,反而会因为门槛降低而迎来爆发式增长。TypeSafe 试图将这一规律复刻在机器决策领域:通过将每一次智能判定的成本降至接近忽略不计,促使开发者在软件各层广泛嵌入智能判断。
三大核心原语与并行采样机制
Jev 与传统大模型最直接的区别在于交互协议。开发者无须编写提示词要求模型“请以 JSON 格式输出”,而是显式定义输出类型边界。目前 Jev 支持三类基础判断原语:
判断原语 | 逻辑定位 | 典型输出形式 | 适用工程场景 |
|---|---|---|---|
Noul | 布尔断言(Yes / No) | 判定结果与置信度概率(如 | 流程门控、任务完成验收、敏感操作拦截 |
Choice | 有限选项单选(Enum Selection) | 预设集合内选项及各选项概率分布 | 工单部门分流、意图路由、交互动作选择 |
Score | 连续打分与等级评定(Rating / Scale) | 归一化分值与置信区间 | 召回结果相关性排序、上下文压缩筛选、风险评级 |
除了固化的类型约束,Jev 的另一项工程特性在于引入了并行采样器(Parallel Sampler)。
在传统大模型中,若希望模型围绕同一段文档回答四个独立问题,模型必须按顺序解码所有问题的分析过程与答案。Jev 则允许开发者在单次 API 请求中挂载多个互不干扰的判断题。例如在处理单张业务发票时,系统可同时发起四个断言:“发票类别属于哪种”、“是否存在金额异常”、“审批等级划分”以及“是否需人工复核”。并行采样器会在单次推理中同步评估这四项结果,大幅缩短排队等待耗时。
// Jev 典型调用请求示意
{
  "context": "用户提交申请:“我购买的商品已超过 30 天,但外包装未拆封,希望能退款。”",
  "decisions": {
    "is_eligible_for_auto_refund": { "type": "noul" },
    "customer_urgency": { "type": "choice", "options": ["low", "medium", "high"] },
    "refund_risk_score": { "type": "score", "min": 0, "max": 100 }
  }
}
Jev 返回的不是自然语言段落,而是每个键值对应的选项与校准概率,可以直接被底层代码中的 if 或 switch 语句消费。
社区真实测试:从上下文压缩到 Agent 裁判
在 Jev 发布后的一周内,海外开发者与工具框架围绕其“快速决策”特性展开了多维度的实测。
1. LangChain 评估器实验(Jev-as-a-Judge)
评估 Agent 执行质量通常依赖高阶生成式模型充当裁判,但长链条评测的调用成本极其高昂。LangChain 于 2026 年 9 月 20 日发布了一项实验,将 Jev 作为自动化评估器,与前沿大型模型进行循环对照测试。
初步实验结果显示,Jev 单次评估调用的平均耗时约为 0.44 秒,调用成本约为 0.00035 美元。在针对固定执行记录进行多次独立复测时,Jev 表现出显著高于通用生成模型的分值一致性,规避了由于生成温度和采样波动带来的评分漂移。
2. 开发环境上下文压缩(fast-jev-compaction)
在长程编程任务中,命令行输出与工具调用日志会迅速占满 Agent 的上下文窗口。开发者 Tamara Tran 为终端智能体 Claude Code 构建了开源扩展 fast-jev-compaction。
该插件把终端产生的冗长输出批量提交给 Jev 的 Score 原语,由模型对各段日志与当前主任务的相关度进行打分,自动剪枝低价值冗余信息后再注入主会话。这一方案大幅缓解了长周期开发过程中的上下文膨胀与 Token 消耗。
3. 高吞吐广告特征提取
开发者 Matthew Berman 公布了一项涉及 37 个品牌、共计 724 条在线广告的分类测试。系统要求模型从广告 Hook 类型、行动呼吁(CTA)、用户认知阶段以及与落地页的一致性等 6 个维度进行结构化标注,单批任务累计触发 8724 次判定。
实测数据显示,该批任务整体处理耗时约 40 秒,单条广告中位耗时为 216 毫秒,全部 8724 次判断产生的 Token 账单仅约 9 美分。
与此同时,开源模型社区也迅速展开复刻研究。Bespoke Labs 推出了开源项目 Nimble,该项目基于 Qwen3.5-9B 使用 2676 条人工整理数据微调出具备 typed decision 能力的轻量本地权重,证明了结构化决策模式本身可以通过开源方案在私有化环境中实现。
拨开宣传迷雾:“零幻觉”与百倍差距的真实边界
伴随社区热度上升,TypeSafe 官方在推广材料中强调的“零幻觉”与“百倍性价比”也引发了工程界的辩证审视。
类型安全性不等于认知正确性
官方宣称的“Zero Hallucinations”常被非技术受众误认为模型彻底解决了理解错误。从技术实现来看,Jev 的零错误实质上是类型错误率(Type Error)为零。
由于模型的解码层被严格限制在枚举字典之内,它绝不会返回未定义的字段名称、破损的 Markdown 标记或非法字符。然而,如果输入语义存在歧义或超出训练分布,Jev 依然可能在给定的合法选项中做出错误选择。格式合规无法自动保证业务逻辑的正确性。
RLCD 概率校准与透明度缺失
TypeSafe 提出采用 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习)来训练模型。传统 RLHF 重在契合人类对话偏好,而 RLCD 致力于让模型输出的置信度与真实命中率对齐。
例如当模型给出 80% 的置信度时,在统计学上对应样本的正确率也应稳定在 80% 左右。若概率校准成立,开发者便能在软件中设立清晰的分流阈值:置信度高于 90% 的任务全自动执行,70% 至 90% 的任务调用轻量模型二次核实,低于 70% 的任务阻断并转交人工审核。
但需要指出的是,TypeSafe 至今未发布正式学术论文,未公开 Jev 的底层网络架构、激活参数规模或消融实验数据。行业尚无法评估其是底层架构的实质创新,还是经典分类网络、微调技巧与工程封装的产物。
基准对比场景的局限性
官方给出的“193.6 倍速度提升”与“444.6 倍成本下降”来自其团队自建的“系统一型”工作流基准。在这一基准中,对比对象均为未做针对性优化的通用前沿大型生成模型,这必然会最大化决策模型的优势。
在现代工程实践中,Google Gemini Flash 与 DeepSeek V4.1 Flash 等高性价比轻量级模型配合 Constrained Decoding 技术(如 JSON 约束生成),同样可以在百毫秒级别内返回严格合规的结构化数据;对于极端追求成本的确定性场景,传统 Embedding 向量分类器的开销甚至更低。Jev 的真实价值取决于多任务并行与通用语义理解能否在综合成本上优于现有工程组合。
独立开发者与小团队的分层系统落地策略
对于独立开发者、OPC(一人公司)与初创工程团队而言,Jev 带来的启示并非盲目引入新 API,而是为生产级 Agent 系统提供了清晰的分层参考架构:
- 规则控制层(Deterministic Logic):继续由常规代码编写。涉及权限校验、本地环境读写、标准数据库 CRUD 等确定性逻辑,无须浪费任何 AI 算力。
- 高频决策层(Decision Model):将高频、重复、低延迟容忍的状态判断交由 Jev、Nimble 等决策模型承载。包括环境状态判定、步骤成功与否的验证门禁、长上下文关键句筛选以及意图路由。
- 复杂生成层(Frontier / Flash LLM):仅在真正需要自然语言交互、多轮对话引导、创意文案构思或复杂程序代码编写时,才激活大型自回归模型。
在具体工程落地时,建议团队遵循审慎原则:优先选择非核心链路的分类和粗筛节点进行试点,并配合严格的置信度阈值监控。在官方提供更详尽的架构白皮书与独立第三方基准报告前,保持对模型在长尾模糊场景下泛化能力的客观评估。