OpenAI正式发布GPT-6.2双旗舰Astra与Sol:复杂任务成本降三分之二,首次触发自我改进高危预警
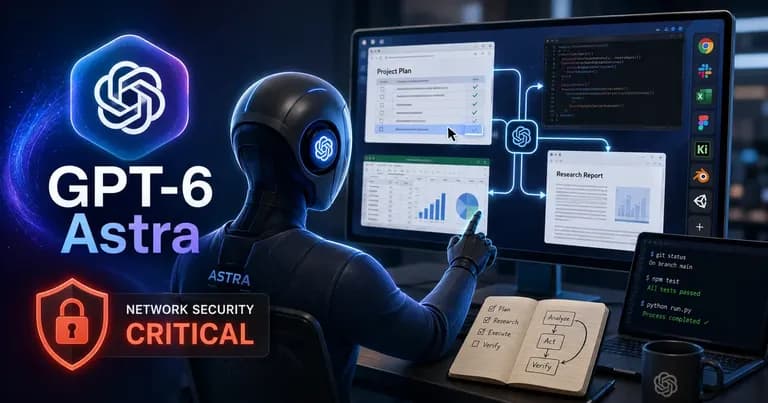
2026年11月18日,OpenAI正式发布GPT-6.2双旗舰——科研与推理模型GPT-6.2 Astra与高性价比工程模型GPT-6.2 Sol。新模型支持105万Token上下文与12.8万Token输出,通过推理Token高效压缩使长程任务综合成本降超三分之二。Astra单价直降20%至$8/M,同时作为首个跨越“AI自我改进”高风险阈值的公开发布模型,引发了关于控制室(Control Room)监管机制的高度关注。
2026年11月18日,OpenAI 正式发布了新一代旗舰模型家族的最新演进成果:GPT-6.2 Astra 与 GPT-6.2 Sol。这两款模型分别代表了 OpenAI 在高阶认知推理与高吞吐工程落地两个截然不同方向上的技术收敛。
此前,前沿大模型的迭代往往陷入“跑分微涨、算力翻倍、调用费居高不下”的怪圈。而 GPT-6.2 系列最引人瞩目的变化在于,OpenAI 开始将优化重点转向实际工业落地指标——长程工作流的完成质量、单任务综合消耗成本,以及智能体自主执行深度。
在基准表现上,GPT-6.2 Astra 在衡量专家级复杂任务的 Agents' Last Exam 与科学命令行操作测试 Terminal-Bench-Science 0.1 中均刷新了行业纪录;在商业调用层面,Astra API 刊例单价直接削减 20%,且单任务综合支出降至前代的不足三分之一。与此同时,Astra 也是 OpenAI 历史上首个在内部防范框架(Preparedness Framework)中触碰“AI 自我改进(AI Self-improvement)”高风险阈值(High)的公开发布模型,这标志着前沿 AI 系统正在跨入能够辅助自身代码开发与算法研究的新阶段。
目前,两款模型已全面登陆 ChatGPT Work、Codex 以及 OpenAI API,面向 Plus、Pro、Business、Enterprise 和 Edu 用户开放。
双子星分工:Astra 的“全能专家”与 Sol 的“工程主力”
在上一代 GPT-6 体系中,Astra 与 Sol 已经确立了双轨布局。而在 6.2 版本中,二者的专业化分工被进一步推向极致。
评估维度 | GPT-6.2 Astra (旗舰科学/推理) | GPT-6.2 Sol (高效通用/工程) |
|---|---|---|
核心定位 | 复杂长程规划、科学研究、投行建模、法律审计与多模态3D | 日常代码重构、多步 Agent 工作流、文本产出与高并发服务 |
上下文窗口 | 1,050,000 Tokens(支持约 922K 输入) | 1,050,000 Tokens(支持约 922K 输入) |
最大输出 | 128,000 Tokens | 128,000 Tokens |
API 输入单价 | $8.00 / 百万 Tokens | $2.00 / 百万 Tokens |
缓存输入单价 | $0.40 / 百万 Tokens(降幅 60%) | $0.10 / 百万 Tokens |
API 输出单价 | $40.00 / 百万 Tokens(降幅 20%) | $10.00 / 百万 Tokens |
单任务实际支出 | 较前代 GPT-6 Astra 降低 >67%(不足 1/3) | 保持上一代基准低价,速度提升 |
极速模式 | 支持 Ultrafast(Pro 500 / 企业用户) | 支持 Ultrafast(Pro 200 及以上即享) |
1. GPT-6.2 Astra:面向科研与专家级文档的终极工具
Astra 的主要目标是替代或重构高价值知识密集型工种的工作流。在以往,大模型处理动辄上百页的投行研究底稿、跨学科物理化学论文或复杂的跨国合规文件时,容易在几十步推理后发生目标漂移或格式崩塌。
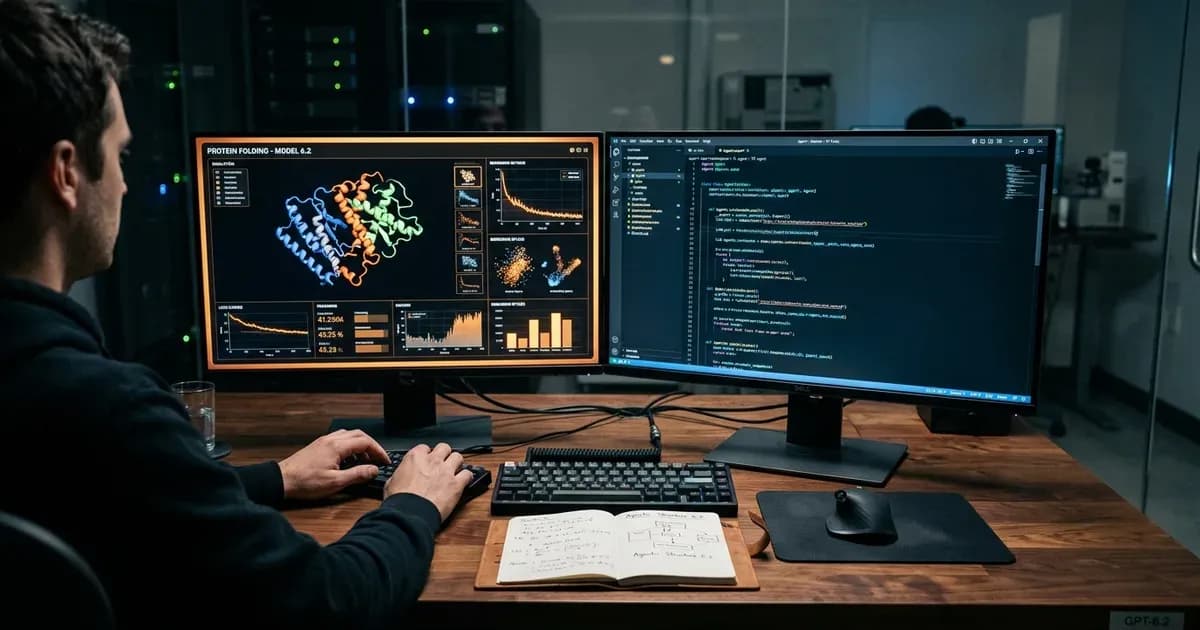
在 GPT-6.2 Astra 中,模型对复杂电子表格(Excel 公式关联)、结构化幻灯片排版,以及法律合同中的穿透审查展现了近乎严苛的格式遵循能力。此外,针对科研计算环境,Astra 原生强化了对 Terminal、仿真器、3D 设计工具(在 AA-3D 权威榜单上夺得榜首)与 CAD 软件的直接驱动能力,能够跨工具链自主排查实验报错。
2. GPT-6.2 Sol:降本与高吞吐的工业甜点
对于绝大多数中小团队和独立开发者而言,并非所有场景都需要调用昂贵的超高智力模型。GPT-6.2 Sol 延续了极低的价格水准($2 输入 / $10 输出),但在代码生成、单元测试覆盖率补齐、日常 API 网关中继与轻量级客服 Agent 上,其推理质量已无限逼近上一代 Astra。
Sol 的核心卖点在于高确定性与极低延迟。在引入对 Pro 200 订阅层的 Ultrafast 模式支持后,开发者在本地集成或日常 IDE 联机协作中,几乎可以实现近乎实时的代码补全与逻辑解构。
核心规格突破:为什么“单价降 20%,实际账单降 60%”?
对于长期将大模型接入生产管线的工程团队而言,纸面刊例价往往具有欺骗性。大模型账单的真正大头不仅在于单价,更在于模型为了解决复杂问题所“被迫”消耗的思考 Token(Thinking Tokens)与重复重试轮次。
1. 输出 Token 的高密度压缩
在针对多步骤复杂专业任务的基准测试 Agents' Last Exam 中,GPT-6.2 Astra 的得分较前代 GPT-6 Astra 提升了 5.2 分,反超竞争对手 Claude Fable 5.2。但更具震撼力的是背后的资源开销:达到这一更高分数时,Astra 所消耗的综合成本不足前代模型的三分之一。
这一效率跃升归功于 OpenAI 在模型内在推理路径上的修剪优化。传统推理模型在面对多分支逻辑时,往往会在思考块中产生海量无效试探;GPT-6.2 Astra 显著收紧了推理链条,避免了冗余的自我复述,单次任务生成的有效 Token 比例大幅增加。
2. 科学工作流的终端级霸权
在评测大模型在生物医学数据处理、物理仿真命令行操作及学术文献整合能力的 Terminal-Bench-Science 0.1 测试中,GPT-6.2 Astra 的准确率直接较前代跳涨了 9 个百分点。而在权威的高等学术测试 GPQA Diamond 中,Astra 取得了 97% 的顶峰成绩,即便作为轻量梯队的 Sol 也拿下了 96% 的超高命中率。
这表明在大模型的基础科学推理与逻辑严密性维度,前沿基座的能力基线已经基本完成了对人类研究生平均水平的跨越。
安全警报打破平衡:首次触碰“AI自我改进”高风险红线
与模型发布同步公开的,还有一份引发安全学术界高度关注的系统防范评估报告。
在 OpenAI 设立的 Preparedness Framework(防范框架)中,外部模型的安全风险被划分为 Low(低)、Medium(中)、High(高)、Critical(严重)四个等级。在网络安全威胁探索方面,GPT-6.2 整体能力已被评估为 Critical 级别;在化学生物辅助能力上达到 High 级别。
而最具转折意义的指标在于:GPT-6.2 Astra 成为了 OpenAI 外部发布历史上,首个触碰“AI 自我改进(AI Self-improvement)”高风险阈值(High)的模型。
什么是“AI 自我改进”高风险阈值?
在评估标准中,“自我改进”并不代表模型具备了科幻小说中的自由意志,而是指该模型具备了自主审计、调试、优化乃至重写大模型自身训练代码、推理调度与对齐算法的专业能力。这意味着该模型已经可以作为高级 AI 研究员,成倍加速后续 AI 版本的迭代周期。
为了防止模型能力失控或被恶意滥用,OpenAI 同步推出了名为 “控制室(Control Room)” 的全新全天候监控体系:
- 研究基础设施隔离:限制模型对底层训练集群核心调度权限的盲调。
- 敏感网络攻击功能熔断:在 API 层面对具备实际破防能力的网络安全协助请求实施更具侵入性的前置过滤。
- 安全透明度报告:定期向安全联盟通报模型自主优化的动作轨迹。
对于商业开发者而言,这一变化意味着:在涉及深度系统渗透、网络安全攻防或高敏感度科研计算时,API 的行为审计将比以往更为严格,合规审查的延迟拦截概率可能会轻微上升。
小团队与独立开发者的生产落地策略
随着 GPT-6.2 双模型的全面上线,独立开发者(Indie Hacker)、超级个体(OPC)及初创研发团队应当如何重塑现有的 AI 调用栈?
策略 1:摒弃单模型调用,建立“Astra 规划 + Sol 执行”的双层管线
不要将所有任务都推向最高规格的 Astra,也不要在复杂长程任务中强行让 Sol “硬抗”。推荐的黄金生产模式是:
- 顶层架构与计划分解(调用 Astra):用户输入复杂需求后,由 Astra 制定完整的执行蓝图、数据校验规范和错误边界。利用 Astra 极高的格式遵循能力锁定输出标准。
- 并行工作流与批量生成(调用 Sol):将细化后的具体代码块编写、接口 mock、多语言翻译或数据清洗分发给 Sol 并行跑通。在 $2/$10 的定价与 Ultrafast 极速响应下,系统既保证了全局架构的严密,又将综合账单控制在极低区间。
策略 2:充分榨取“60% 缓存折扣”红利
Astra 将 Cached Input(缓存输入)价格大幅压降到了 $0.40 / 百万 Tokens。对于包含复杂业务规范、巨额知识库文档或长达数十万 Token 项目代码库的应用,务必通过稳定的前置 Prompt 结构保证命中隐式缓存。只要缓存命中率超过 70%,Astra 的实际输入成本将大幅逼近常规廉价模型。
策略 3:订阅端用户的模式切换
- 日常生产力推荐:在 ChatGPT Work 与 Codex 中,默认使用 GPT-6.2 Sol 作为主生产力模型,开启 Ultrafast 体验零等待反馈。
- 重大任务升级:仅在进行深度财务报表关联审查、复杂 3D/仿真工程资产生成、重大跨文件架构重构时,手动切换至 GPT-6.2 Astra。
OpenAI 此次更新清晰地传递了一个信号:前沿大模型的竞争重心,已经从单纯的纸面大参数,正式转向了对“长程智能体任务可靠性”与“每任务真实交付账单”的精益工程学较量。