Claude Sonnet 5.5发布:单价不变任务成本降三成,Terminal-Bench首度反超同代Opus
Anthropic正式发布Claude 5.5家族第二款模型Sonnet 5.5。新模型维持每百万Token输入2美元、输出10美元的基准单价,凭借更紧凑的输出与更少的工具调用将综合任务成本压低最多30%,并在Terminal-Bench 4.0上以70.6%的成绩首度反超同代Opus。伴随五档思考力度调节、512 Token缓存门槛降低与原生100万上下文开放,中端主力模型的工程效费比正在被重写。
2026年9月28日,Anthropic正式发布Claude 5.5家族第二款模型Claude Sonnet 5.5。距离9月22日旗舰级Opus 5.5上线仅过去6天,Anthropic便补齐了主力中端梯队,而定位高并发与成本敏感场景的Claude Haiku 5.5也已确认将在未来数周内加入产品线。
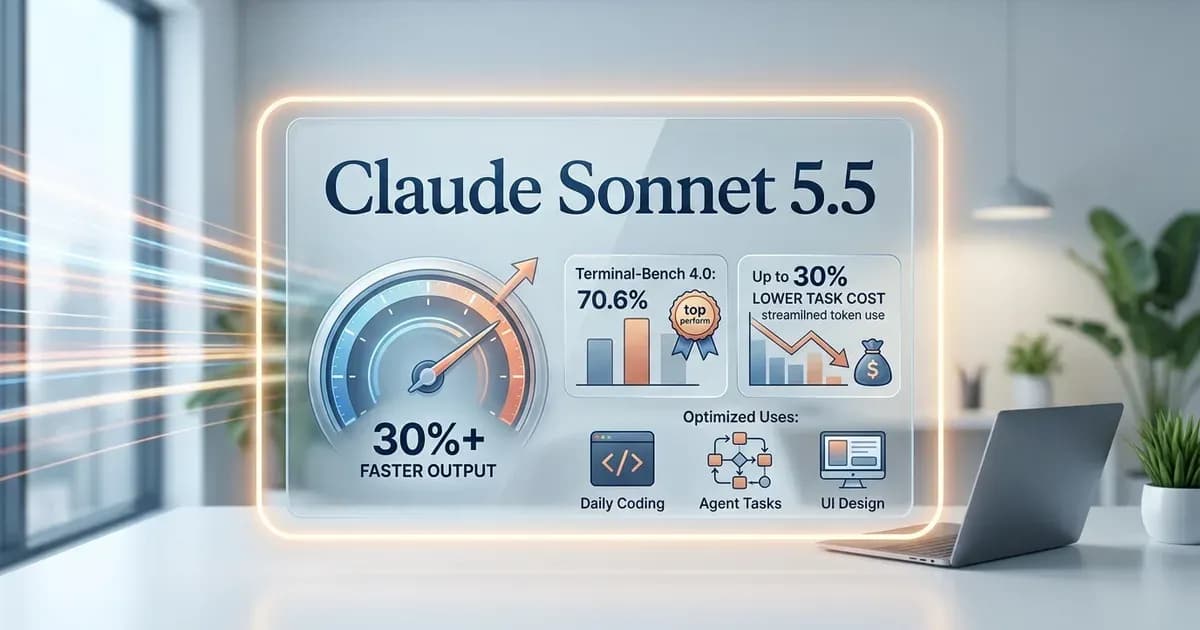
这次迭代中,Sonnet 5.5最受工程团队关注的改变体现在速度、成本与编程能力三项核心指标上:模型输出速度较Sonnet 5提升30%以上;在API输入每百万Token 2美元、输出10美元基准单价维持不变的前提下,通过减少完成任务所需的Token消耗,将多数工作的综合执行成本压低最多30%;而在智能体终端编程基准Terminal-Bench 4.0中,Sonnet 5.5取得70.6%的高分,不仅远超前代Sonnet 5的10.3%,更在Sonnet产品历史上首次在公开基准中反超同代旗舰Opus 5.5(66.4%)。
性能跃升与基准分工:Terminal-Bench首超Opus与日常工程定位
在官方与第三方公布的基准测试中,Sonnet 5.5的提升覆盖了编程智能体、跨领域知识工作以及长周期多模态理解。
在考察命令行真实工程交互的Terminal-Bench 4.0评估中,Sonnet 5.5在Max思考档位下取得70.6%的成绩,而Sonnet 5在所有档位下的历史最好成绩仅为10.3%,Opus 5.5在Xhigh档位下的最高成绩为66.4%。在抽取自真实Cursor多文件编码任务的CursorBench 4.0中,Sonnet 5.5得分达到55.5%,相比前代的34.1%提升超过21个百分点,与Opus 5.5(57.8%)仅差2.3个百分点。
知识工作与推理评测同样呈现出紧咬旗舰的趋势。在涵盖44类职业真实任务的GDPval-AA v2.1基准中,Sonnet 5.5获得1844分,与Opus 5.5的1846分仅有2分之差,远超Sonnet 5的1449分与GPT-6 Sol的1487分。在考察长周期知识工作的AA-Briefcase v1.1中,Sonnet 5.5达到1811分,逼近Opus 5.5的1822分。在多模态与长链路操作上,Sonnet 5.5在桌面系统自动化评估OSWorld 2.1中取得80.1%,图表理解Chartography得分从前代的15.6%跃升至61.6%,并成为首个仅凭连续游戏截屏通关《精灵宝可梦·红》(Pokémon Red)的Sonnet模型。
评测基准 | 评估领域 | Sonnet 5.5 | Sonnet 5 (上一代) | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|---|
Terminal-Bench 4.0 | 终端环境编程Agent | 70.6% (Max) | 10.3% | 66.4% (Xhigh) | — |
FrontierCode 1.1 | 真实代码合并评估 | 52.1% (Xhigh) / 46.2% (Max) | 42.4% | 54.4% | 49.3% |
CursorBench 4.0 | 跨文件多步骤编码 | 55.5% | 34.1% | 57.8% | — |
GDPval-AA v2.1 | 跨职业知识工作 (Elo) | 1844 | 1449 | 1846 | 1487 |
AA-Briefcase v1.1 | 长周期综合知识工作 (Elo) | 1811 | 1359 | 1822 | 1483 |
Humanity’s Last Exam | 跨学科高阶推理 (带工具) | 64.5% | 54.9% | 67.7% | — |
OSWorld 2.1 | 计算机桌面自动化操作 | 80.1% | 57.0% | 81.8% | — |
Chartography | 纯视觉图表解析 (无工具) | 61.6% | 15.6% | 64.4% | 53.6% |
基准数据虽然显眼,但并未改变两款模型的工程定位。Anthropic在公告与系统说明中给出了明确的分工界定:Opus 5.5依然针对需要持续权衡、深度判断以及高不确定性的复杂开放任务;Sonnet 5.5则定位于边界明确的日常开发、故障排查、以及文档、幻灯片和表格制作,同时具备更强的视觉与界面设计把控力。
根据早期工程测试反馈,Sonnet 5.5在理解大型代码库架构时展现出更高的工具调用聚合度。在相同开发任务中,它倾向于单次批量发起相关工具调用,使得Shell执行次数减少约50%,工具交互轮次降低约三分之一,大幅压缩了等待响应的空转时间。
成本与效率逻辑:单价为何不变,任务账单却能缩减三成
API定价方面,Sonnet 5.5延续了Sonnet 5的标准定价,并未在单价数字上做调整:
计费与运行维度 | Sonnet 5.5 | Opus 5.5 | Sonnet 5 (上一代) | 变动说明 |
|---|---|---|---|---|
输入价格 (每百万Token) | $2.00 | $4.00 | $2.00 | 与前代持平,为Opus 5.5的一半 |
输出价格 (每百万Token) | $10.00 | $20.00 | $10.00 | 与前代持平,为Opus 5.5的一半 |
Prompt缓存写入 (每百万Token) | $2.50 | $5.00 | $2.50 | 与前代持平 |
Prompt缓存读取 (每百万Token) | $0.20 | $0.20 | $0.20 | 与Opus 5.5同档 |
最小可缓存前缀 | 512 Token | 1024 Token | 1024 Token | 门槛减半,短提示亦可命中缓存 |
原生上下文窗口 | 100万 Token | 100万 Token | 20万 Token (100万需Beta) | 原生开放,无需附加Header |
单次最大输出 | 12.8万 Token | 12.8万 Token | 8192 Token | 支持极长代码与文档生成 |
知识库截止日期 | 2026年6月 | 2026年6月 | 2025年11月 | 覆盖最新开源生态与框架 |
单价没有下降,官方提出的“成本最高降低30%”来自完成同一项任务所消耗的Token总数缩减。
在实际开发场景中,模型往往需要经过多次推理、代码生成、自我校验与工具调用。实测表明,在网页动画组件渲染等典型任务中,Sonnet 5.5生成的代码更紧凑,单次交互所消耗的Token较Sonnet 5减少约10%到15%;而在智能体多轮排障流程中,由于减少了无效工具试探与多余的代码审查中间步骤,累积Token开销进一步拉开差距。
另一个影响小团队开销的细节是Prompt缓存门槛的下调。此前Prompt Caching要求提示词前缀至少达到1024个Token才能激活缓存,Sonnet 5.5将这一门槛降至512个Token。对于将小型工具Schema、通用角色约束或简短规则集注入对话的应用,短文本请求也能享受0.20美元/百万Token的缓存读取费率,降低了高频微型Agent的调用成本。
“思考力度”五档调节:推理深度为何不能无脑拉满
Sonnet 5.5将此前隐藏在后台的模型推理深度转化为用户可见且可配置的“思考力度”(Thinking Effort),设立Low、Medium、High、Xhigh、Max五个档位:
- Low / Medium 档位:推理步数精简,响应更快且消耗更少Token,适合日常代码补全、文档生成、单函数Bug修复等边界清晰的任务;
- High / Xhigh / Max 档位:模型在生成最终答案前展开多轮自我检查、假设验证与分支推演,准确率提升但单次调用的Token消耗与时延同步上升。
不同运行环境的默认档位存在差异:Claude Code命令行工具与Claude网页端默认运行在Medium档位,而Claude Platform开发者API默认设置为High档位。
思考档位不能一味拉满,在部分基准中选择最高档位反而会导致成绩下滑。在考察代码变更能否无人工修改直接合入的FrontierCode 1.1测试中,Sonnet 5.5在Xhigh档位拿到52.1%,但在Max档位却降至46.2%。
测试排查表明,FrontierCode严格惩罚超出任务范围的代码变动。当思考力度开到Max时,Sonnet 5.5更倾向于在底层自动调用Claude Code内置的代码审查技能,将审查任务拆分给多个并发子智能体执行;这种过度的自主发散在两起典型案例中直接触发了单任务执行超时,或引入了与原需求无关的高质量额外重构,进而被判为超出变更范围而扣分。这表明“思考力度”更接近需要按场景校准的调优参数,盲目设为Max可能带来意料之外的时间与Token损耗。
API与工程升级须知:四项阻断性接口变更与迁移要点
对于正在将生产系统从Sonnet 5或Opus 5迁移至Sonnet 5.5的开发者,此次发布包含四项可能导致旧代码报错的硬性变更:
1. 自适应思考强制开启与400报错
Sonnet 5.5默认开启自适应思考(Adaptive Thinking)。在调用API时,如果请求体仍然携带旧版的关闭参数:
{
  "thinking": {
    "type": "disabled"
  }
}
接口将直接返回HTTP 400错误。如果开发者需要关闭生成正文前的前置深度推理,必须采用官方新增的between_tools设置,将思考限制在工具交互间隙而非全程前置。
2. 响应Block遍历与解析异常
由于自适应思考默认运行,API返回的内容结构中,首个Content Block通常是thinking类型的推理过程,而非直接包含正文文本的text类型。
如果客户端代码存在类似response.content[0].text的直接下标取值逻辑,升级后将抛出属性不存在或空值异常。生产代码必须改为按Block类型遍历解析,提取type === 'text'的内容块进行后续业务处理。
3. tool_choice 参数收紧
在工具调用配置上,Anthropic移除了tool_choice中的any和tool选项。传入这两种取值同样会触发HTTP 400校验失败。需要强制或引导模型使用工具时,应当配置为auto并配合strict: true模式,通过清晰的系统提示词(System Prompt)界定工具触发条件。
4. 计算机使用与CLI别名指向
使用计算机操作(Computer Use)功能的系统,必须将工具集定义迁移至computer_toolset_20260801,旧版工具定义不再受支持。
在开发工具链层面,Claude Code从v2.1.284版本起将内置的sonnet别名直接映射为Sonnet 5.5,并默认以Medium档位运行。不过Claude Code的全局默认模型仍维持为Opus 5.5,工程师需在控制台手动输入/model sonnet完成切换。
安全架构与防御下放:高危任务回退与蒸馏防护
随着中端模型推理与代码生成能力的跃升,Anthropic首次将此前仅配置在旗舰梯队的安全机制下放到Sonnet级别:
- 网络安全防御与可见回退:Sonnet 5.5具备匹敌Opus 5的网络安全分析能力。为防范高危漏洞利用,系统部署了与Opus 5.5类似的安全守卫;当模型检测到高风险渗透或攻击性任务时,调用请求会可见地回退至更为保守的Sonnet 5执行。网络安全专业防御者可通过申请拓展的“网络安全认证计划”(Cyber Verification Program)获取更高权限。
- 生物风险过滤:沿用与Sonnet 5相同的生物安全过滤器,针对特定高危生物制剂请求实施拦截,常规生命科学与医学研究可申请“生命科学认证计划”。
- 防范工业级模型蒸馏:面对利用大量虚假账号抓取高质量推理轨迹以训练竞品模型的工业级蒸馏行为,Sonnet 5.5首次上线专用安全分类器拦截推理抓取,并扩大了“留存思考”(Preserved Thinking)机制,将推理过程严格绑定至创建该会话的账户,防止推理轨迹被脱离上下文导出。
- 零数据留存与多云分发:Sonnet 5.5同样支持零数据留存(Zero Data Retention, ZDR),目前已在AWS Bedrock、Google Cloud Vertex AI、Microsoft Azure以及Claude官方平台同步上架,API模型标识符为
claude-sonnet-5-5。
独立开发者与小团队的工程落地指南
综合速度、成本、基准表现与接口变动,独立开发者、OPC一人公司以及资源有限的创业团队在引入Sonnet 5.5时,可参考以下落地路径:
- 分层分流:日常交付切入Sonnet 5.5,疑难决策保留Opus 5.5 日常的全栈代码编写、前端组件设计、单测生成、文档维护与数据清洗工作,直接交由Sonnet 5.5处理。其执行速度提升30%、工具调用聚合度更高,单任务总成本大幅低于Opus 5.5;而对于大型系统架构设计、开放式技术选型与跨模块高难度排障,仍建议交由持续判断力更强的Opus 5.5。
- 严控思考档位:以Medium为基线,避免盲目拉满Max 在自动化流水线或日常开发工具中,保持默认的Medium档位(Claude Code与网页应用预设),API端根据复杂度在Low与Medium间评估。仅在算法竞赛、数学证明或极复杂的AST变换时尝试High;在自动化Agent工作流中避免使用Max档位,防止子智能体过度发散导致任务超时或无关代码篡改。
- 重构Prompt设计与Prompt Caching利用率 利用降至512 Token的缓存门槛,将团队内部的通用Coding Style、常用第三方库接口定义、统一项目规范等模块化拆分为500~800 Token的前置提示词块。高频调用时可稳定命中0.20美元/百万Token的缓存读取单价,将反复执行的智能体调用成本再削减一半以上。
- 上线前排查接口调用代码 在修改配置切换模型标识符为
claude-sonnet-5-5之前,务必全面审查代码库:替换已废弃的thinking: {"type": "disabled"}、修正直接读取content[0].text的脆弱逻辑、将tool_choice迁移至auto并启用strict: true,确保生产服务平滑过渡。