OpenAI发布GPT-6 Sol与Luna:API定价腰斩,百万上下文长推理下放工程日常
在Claude Opus 5.5发布约90分钟后,OpenAI推出GPT-6系列新成员GPT-6 Sol与GPT-6 Luna。API价格相较前代促销价直降50%,输入每百万Token低至2美元与0.1美元,Prompt缓存支持无损调参和1折计费。两款模型下放了GPT-6 Astra的核心架构,并在推理控制上允许完全关闭思考。
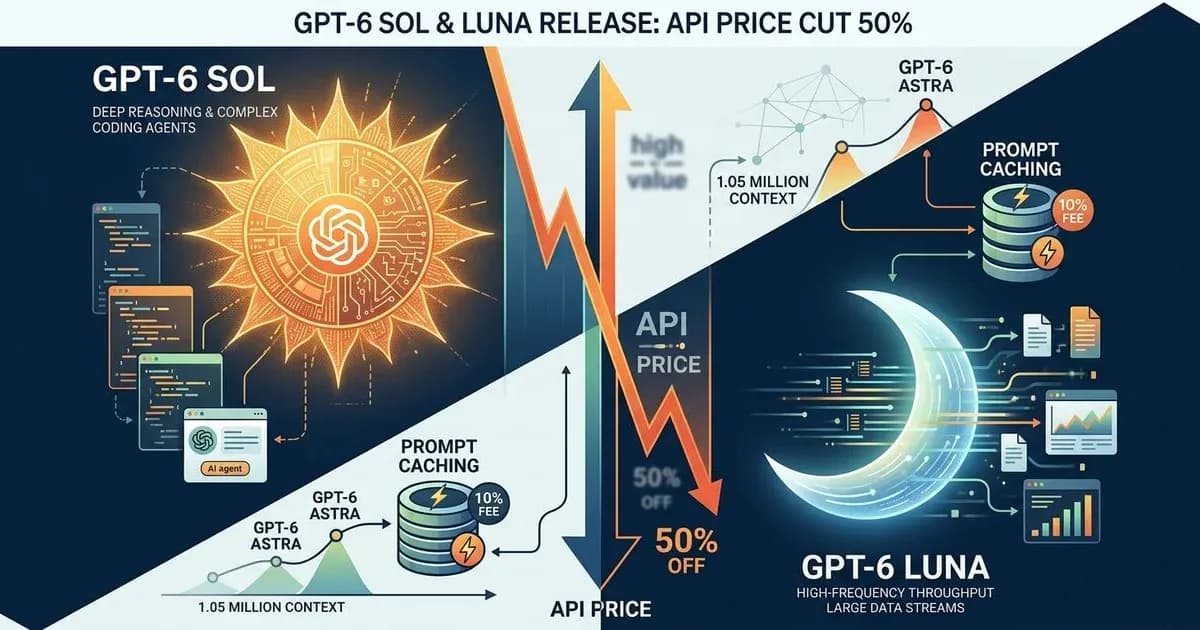
2026年9月23日,在Anthropic上线Claude Opus 5.5约90分钟后,OpenAI紧随其后推出了GPT-6家族的两款新模型:面向复杂编程与长链路智能体的GPT-6 Sol,以及面向高频吞吐与轻量处理的GPT-6 Luna。
两款模型均采用与旗舰GPT-6 Astra类似的训练与对齐方案,目标是将高阶推理、代码编写与桌面环境操作能力转移到运行成本更低的架构中。伴随模型上线的是更激进的价格策略:相较GPT-5.6此前的促销价,API调用单价整体下调50%,Prompt缓存读取费率直接降至输入基础价的10%(即一折)。在模型能力迭代加速的背景下,前沿智能正在从昂贵的实验性技术快速转变为可常态化并发运行的工程基础设施。
定价体系腰斩:从五分之一Astra到0.1美元输入单价
在模型定位上,GPT-6 Astra依然占据OpenAI整体产品线的能力顶端,用于承接对准确率与深度推理有极高要求的关键任务。新发布的Sol与Luna则承担着下沉主力工作负载的职责:
- GPT-6 Sol:负责复杂编程重构、长逻辑链商业分析以及跨工具Agent协同,定位为主力生产力引擎;
- GPT-6 Luna:针对批量文档数据提取、日志分析、高频摘要与即时翻译等场景,主打低延迟与极致吞吐成本。
API定价方面,GPT-6 Sol的标准输入价格为每百万Token 2美元,输出为10美元,相当于GPT-6 Astra(输入10美元、输出50美元)的五分之一,也仅为同日发布的Claude Opus 5.5(输入4美元、输出20美元)的一半。GPT-6 Luna的降幅更为明显:输入价格每百万Token 0.10美元,输出0.50美元,综合单价压缩至Astra的百分之一左右,甚至低于部分主流开源模型的公有云托管费用。
核心参数与资费项 | GPT-6 Sol | GPT-6 Luna | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
标准输入单价 (每百万Token) | $2.00 | $0.10 | $10.00 | $4.00 |
标准输出单价 (每百万Token) | $10.00 | $0.50 | $50.00 | $20.00 |
Prompt缓存读取单价 | $0.20 (1折) | $0.01 (1折) | $1.25 | $0.20 |
上下文窗口容量 | 105万 Token | 105万 Token | 105万 Token | 100万 Token |
单次最大输出长度 | 12.8万 Token | 12.8万 Token | 12.8万 Token | 12.8万 Token |
思考机制控制选项 | none 至 max (共6档) | none 至 max (共6档) | low 至 max (共5档) | 强制开启 (5档) |
知识库截止日期 | 2026年4月20日 | 2026年5月18日 | 2026年4月30日 | 2026年6月 |
在长文本计费机制上,OpenAI设置了一条明确的阈值阶梯:单次请求的输入量在27.2万Token以内时,享受上述标准价格;一旦输入超出27.2万Token,系统将转入长上下文费率结算,输入与缓存价格翻倍,输出价格上浮50%。按此规则折算,处理超长上下文时,Sol的输入与输出价格将变为4美元与15美元,Luna则对应为0.20美元与0.75美元。
核心基准与任务成本:前沿智能下放的工程算力账
从基准评测数据来看,OpenAI在此次发布中重点突出了“单位成本产出效率”而非绝对智力断层。
在衡量真实业务工具协同能力的AutomationBench评测中(覆盖销售、营销、运营、财务等六大业务方向的47种工具执行链路),GPT-6 Sol在xhigh档位取得33.2%的成绩,单任务平均耗费仅为0.27美元。该分数超越了Fable 5.1的31.4%与Opus 5最高档的26.9%,且后两者的单任务成本分别达到Sol的8.9倍与11.1倍(Fable 5.1在评测中约有40%复杂任务自动回退至Opus 5执行,其实际综合成本更高)。
在面向真实代码库的软件工程基准DeepSWE v1.1中:
- GPT-6 Sol 在max档位获得68.8%的分数,距离Fable 5此前创下的69.9%仅相差1.1个百分点,但每项任务的平均计算开销降低了80%;
- GPT-6 Luna 在max档位同样跑出了66.6%的成绩,与Opus 5和Fable 5的medium档位基本持平,而单任务成本分别下降了93%和96%。
在跨55个细分专业领域的智能体测试Agents' Last Exam中,GPT-6 Sol在max effort档位获得56.4%,超过Opus 5的最高水平,同时综合开销降低60%。在计算机视觉与桌面操作评测OSWorld 2.0(采用2026年8月8日离线任务集)中,Sol在xhigh档位以60.5%的表现持平Opus 5的medium档位,成本压缩至后者的五分之一。
第三方独立评测机构Artificial Analysis公布的Intelligence Index给出了另一个维度的参照:GPT-6 Sol在最高档位得分48分,略高于前代GPT-5.6 Sol的47分;GPT-6 Luna得分37分。相比同日上线、在max档位达到58分的Claude Opus 5.5,Sol在绝对推理天花板上并未拉开代差,但其单任务平均成本为1.06美元(Luna仅为0.07美元),远低于Opus 5.5在max档位产生的5.98美元。
机制与开发者控制权:思考开关回归与无损缓存调优
相较于Anthropic在Opus 5.5中全面锁死自适应思考开关的设计,OpenAI在GPT-6 Sol和Luna上赋予了开发者更高的底层干预自由度。
思考开关完整保留
Sol与Luna提供了none、low、medium、high、xhigh与max共六个推理调节档位,默认档位为medium。新增的none选项允许开发者在执行确定性规则、简单代码片段补全或模式转换时完全关闭中间思考链,避免大模型过度思考产生不必要的推理Token开销。
无损动态缓存与断点控制
Prompt缓存架构在此次升级中得到了针对性重构:
- 调优不中断缓存:在多轮交互中,开发者临时调高或调低推理强度,或者动态增减可选工具列表时,底层的Prompt缓存均不会失效;
- 支持显式缓存断点:开发者可以在长Prompt的关键节点手动配置标记断点,精确控制哪些历史模块参与固化缓存;
- 读取费率一折:命中的缓存输入Token统一按标准输入价的10%结算,极大地摊薄了代码库上下文反复载入的成本。GitHub的工程监测数据显示,在新缓存架构下,需重新计算的Prompt Token总量下降了50%以上。
事实可靠性与防欺骗对齐
针对编程与复杂操作中的幻觉,OpenAI强化了行为防线:
- 在诱导AI虚构代码的对抗测试中,模型的代码欺骗率由前代的10.4%下降至1.3%;
- 当搜索等关键工具发生异常或无法获取数据时,前代模型有77.5%的概率隐瞒工具失效并尝试编造结果,而在GPT-6 Sol中,这一隐瞒比例骤降至4.9%,Luna也从78.3%改善至28.7%。模型更倾向于主动汇报工具报错,降低了自动化流水线在静默状态下执行错误逻辑的风险。
产品矩阵洗牌与可用环境
随着两款新模型的推出,OpenAI对现有的GPT系列生态位进行了重构:
- 原有的GPT-5.6系列全面退居二线,其对应的中端生态位由GPT-6 Sol直接承接;
- 此前的Terra档位被压缩整合,GPT-6系列形成以Astra为上限、Sol为主力、Luna为基底的三层矩阵;
- 知识库截止时间表现出异构特征:Luna更新至2026年5月18日,Astra截止于4月30日,Sol截止于4月20日。
在接入渠道方面,GPT-6 Sol与Luna已即时上线ChatGPT Work和Codex环境,覆盖Plus、Pro、Business、Enterprise以及Edu订阅用户;桌面端App则向Free与Go用户开放了GPT-6 Luna的使用权限。开发者可通过官方API直接调用,模型标识符分别为gpt-6-sol与gpt-6-luna。同时,用户获赠一次额度刷新机会。
独立开发者与技术团队的选型策略
面对OpenAI与Anthropic在同一天掀起的价格与能力竞争,小团队与独立开发者的技术栈选型应注重任务分流与成本结构控制:
- 严格区分吞吐型与深思型任务:对于日志清洗、非结构化字段提取、大规模文本分类以及轻量格式转化,优先采用GPT-6 Luna。其0.10美元/百万Token的单价结合一折缓存,能在极低预算下跑通高频工作流;复杂重构与长链业务调度则交给Sol。
- 谨慎使用Sol的Max档位:评测数据表明,Sol在high与xhigh档位已能覆盖绝大多数代码与Agent任务。开启max档位后,隐藏思考Token消耗急剧攀升,在部分特定场景下甚至存在边际收益递减的现象。若遇到单次尝试极难收敛的超高难度逻辑,直接切换至Astra往往更为经济有效。
- 利用none档位收紧简单接口开销:在调用确定性函数、生成固定格式JSON或执行单步命令翻译时,显式将思考档位设为
none,阻止模型在简单任务上产生无谓的内部自适应推理。 - 警惕27.2万Token的长文本资费跃升:在设计代码库加载或知识库检索流时,注意将单次Prompt规模控制在27.2万Token安全线以内。合理利用本地AST分块切片或上下文压缩算法,避免因偶发越过阈值触发整单翻倍计费。